Pourquoi posons-nous nos questions à l’IA en premier?
Lors d'une errance scrollante, un graphique m’a arrêtée net : les questions posées sur Stack Overflow, le grand forum d’entraide des développeurs, sont retombées à leur niveau de 2009. Mon premier réflexe a été d’accuser l’IA. Puis j'ai regardé de plus près. Et j'ai compris que l'histoire était moins simple, et qu'elle me concernait peut-être directement.
Ce fameux graphique montrait le nombre de questions posées chaque mois sur Stack Overflow, le plus grand forum d’entraide entre développeurs. Au plus fort, vers 2014, il en recevait environ 200 000 par mois. En mai 2025, la courbe était retombée à son niveau de 2009, l’année de son lancement.
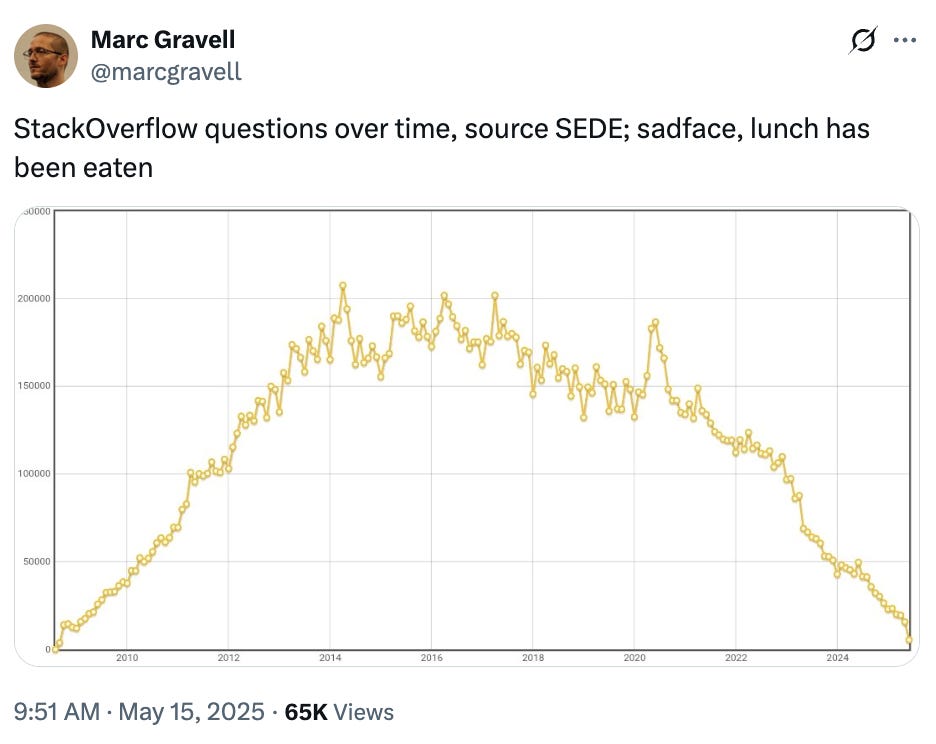
Source: Stack Overflow Data Explorer (SEDE) / Marc Gravell (L’un des top 10 contributeur à Stack Overflow) sur X
Ce que dit vraiment la courbe
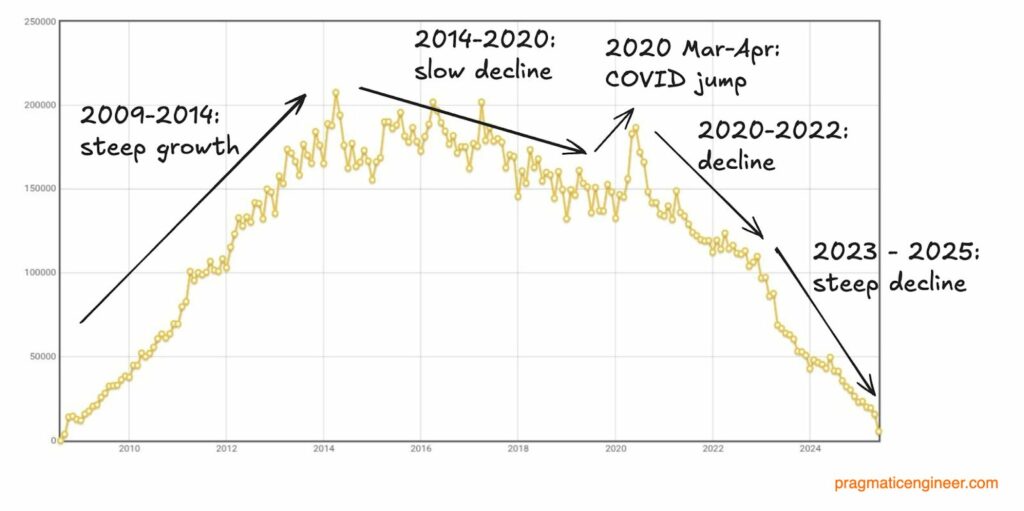
Le déclin n’a pas commencé avec ChatGPT. D’après l’analyse de Gergely Orosz dans The Pragmatic Engineer, basée sur les données publiques du forum, il remonte à 2014, l’année où Stack Overflow a rendu sa modération beaucoup plus efficace : les questions jugées en double ou de mauvaise qualité étaient fermées plus vite et plus souvent. Pour beaucoup de nouveaux venus, l’accueil est devenu froid.
Une deuxième baisse, plus nette, apparaît dès juin 2020, deux ans avant l’arrivée de ChatGPT. Puis, à partir de novembre 2022, la chute devient vertigineuse. Avec ces données, le graphe devient plus compréhensible :
Le vrai et le faux, donc :
- Faux : l’IA a tué Stack Overflow à elle seule.
- Vrai : l’IA a accéléré un déclin déjà en cours, en offrant exactement ce qui manquait au forum : une réponse immédiate, polie, sans jugement.
Cette nuance compte. Si l’IA a gagné aussi vite, c’est aussi parce qu’elle répondait à une frustration réelle.
Et ma pratique dans tout ça ?
Ce graphique me renvoie surtout à moi-même. J’ai un profil plus chercheuse que contributrice sur les forums et le dernier message que j’ai posté sur un forum d’entraide remonte à quatre ans. Je galérais sur un problème d’hébergeur et quelqu’un m’a aidée à trouver la solution. (Que le service client n’avait pas trouvé lui en 7 jours). Aujourd’hui, face à un problème technique, une fois sur quatre, mon premier geste est d’ouvrir une conversation avec une IA.
Alors je me suis posé la question : suis-je la seule ? Visiblement non. Dans l’enquête annuelle de Stack Overflow de 2025, 84 % des développeurs interrogés utilisaient ou prévoyaient d’utiliser des outils d’IA dans leur travail, contre 76 % un an plus tôt.
Mais le chiffre le plus intéressant est ailleurs : dans la même enquête, 46 % disent ne pas faire confiance à l’exactitude de ces outils, contre 31 % l’année précédente. Plus de développeurs s’en méfient (46 %) qu’ils ne leur font confiance (33 %).
Nous utilisons donc l’IA de plus en plus, tout en la croyant de moins en moins. C’est précisément ce paradoxe qui m’intéresse. Comme je l’ai déjà mentionné dans un article précédent, j’utilise l’IA comme un outil de travail et je refuse qu’elle devienne ma première et unique interlocutrice.
Un réflexe qu’on nous installe aussi
Cependant, il serait trop simple de dire que tout vient de nous. L’IA ne se contente plus d’attendre qu’on vienne la chercher : elle s’installe là où l’on cherchait déjà.
Sur Google, un résumé généré par IA s’affiche désormais en haut de nombreux résultats. Le Pew Research Center a observé le comportement réel de 900 adultes américains en mars 2025 : quand ce résumé apparaissait, ils cliquaient sur un lien dans 8 % des cas, contre 15 % sans résumé. Et les sources citées dans le résumé lui-même n’étaient ouvertes que dans 1 % des visites.
Autrement dit, même quand on croit faire une « recherche classique », on lit de plus en plus souvent une réponse d’IA sans jamais aller voir d’où elle vient. Le réflexe n’est pas qu’une habitude personnelle, il est aussi dessiné par les outils qu’on utilise.
Le tête-à-tête avec l’IA, pas l’idée du siècle
Quand on pose une question à une IA, il n’y a personne d’autre dans la pièce. La réponse arrive vite, bien rédigée, polie. Elle ne garde aucune trace du doute qui aurait pu exister. C’est précisément ce confort qui rend l’erreur difficile à voir.
Sur un forum, au contraire, la réponse n’arrive jamais seule. Quelqu’un la complète, un autre la conteste, un troisième signale qu’elle ne fonctionne plus depuis la dernière mise à jour.
Les forums n’étaient pas parfaits pour autant. Des réponses fausses restaient en tête pendant des années, et l’accueil y était parfois rude. Mais le désaccord, lui, était visible.
L’IA, celle qui vous vendrait un chat dans un sac
Il vous est sûrement arrivé de lire une réponse d’IA en haussant un sourcil, parce que vous connaissiez le sujet ou parce que l’erreur était flagrante. C’est ce qu’on appelle une hallucination.
Une hallucination, c’est une réponse fausse présentée avec l’assurance d’une réponse vraie. L’IA ne ment pas volontairement : elle produit ce qui lui semble le plus plausible et le plausible n’est pas toujours le vrai.
Quelques exemples courants :
- une citation attribuée à la mauvaise personne ;
- un article ou un livre qui n’existe pas ;
- une date, un prix ou un chiffre inventé ;
- une fonctionnalité de logiciel qui n’a jamais existé.
Pourquoi l’IA se trompe-t-elle avec autant d’assurance ?
Le 5 septembre 2025, des chercheurs d’OpenAI ont publié une étude sur cette question. Ils y identifient deux causes principales et reconnaissent que le problème concerne tous les grands modèles de langage, pas seulement les leurs.
Première cause : les informations rares
Une IA apprend en repérant des régularités dans d’immenses quantités de textes. L’orthographe ou la grammaire suivent des règles : elle les maîtrise donc très bien.
Mais la date d’anniversaire d’une personne peu connue ne suit aucune règle. Quand une information est rare, l’IA comble le vide avec quelque chose de vraisemblable. Les chercheurs racontent d’ailleurs avoir demandé à un chatbot la date de naissance de l’un d’entre eux : ils ont obtenu trois dates différentes, toutes fausses.
Deuxième cause : une notation qui récompense le pari
Imaginez un examen à choix multiples sans points négatifs. Si vous ne savez pas, répondre au hasard vaut toujours mieux que laisser la case vide.
Les IA sont évaluées un peu de la même manière : on compte surtout leurs bonnes réponses. Elles ont donc appris qu’il vaut mieux tenter sa chance que dire « je ne sais pas ».
Les chercheurs donnent un exemple parlant, sur un même test de questions factuelles (SimpleQA) :
| Modèle | Bonnes réponses | Erreurs | « Je ne sais pas » |
|---|---|---|---|
| Ancien modèle (o4-mini) | 24 % | 75 % | 1 % |
| Modèle plus récent (gpt-5-thinking-mini) | 22 % | 26 % | 52 % |
Sur le papier, l’ancien modèle semble meilleur : il a légèrement plus de bonnes réponses. En pratique, il se trompe presque trois fois plus souvent. Le plus récent n’est pas plus savant, il ose simplement dire quand il ne sait pas.
« Bah, demande à une autre IA » : le faux bon réflexe
Ah, ce conseil donné par le voisin, l’oncle, le copain à qui on n’avait rien demandé… Après tout, si ChatGPT, Gemini et Claude disent la même chose, c’est que ça doit être vrai, non ? Eh bien, pas vraiment.
Une étude présentée en juillet 2025 à ICML, l’une des grandes conférences sur l’IA, a comparé plus de 350 modèles. Sur l’un des tests, quand deux IA se trompaient toutes les deux, elles donnaient la même mauvaise réponse dans 60 % des cas.
Plus surprenant encore : ce sont les modèles les plus grands et les plus performants dont les erreurs se ressemblent le plus, même lorsqu’ils viennent d’entreprises différentes.
L’explication est assez simple. Ces IA apprennent sur des textes en grande partie communs, avec des méthodes proches. Deux IA d’accord ne forment donc pas deux avis indépendants. C’est parfois la même erreur, répétée deux fois.
Le cercle qui se referme
Il y a aussi un effet à plus long terme. Les IA ont appris en partie grâce aux forums comme Stack Overflow. Si nous arrêtons d’y poser nos questions, elles auront moins de débats humains récents dont s’inspirer.
Des chercheurs d’Oxford et de Cambridge ont montré dans la revue Nature, en 2024, qu’entraîner des modèles sur des textes eux-mêmes produits par des IA, génération après génération, finit par les appauvrir : les cas rares disparaissent en premier. Leurs expériences restent menées en laboratoire et les entreprises filtrent leurs données pour limiter ce risque. Mais leur conclusion est claire : les échanges réellement humains vont devenir de plus en plus précieux.
Chaque question que nous ne posons plus en public est donc aussi une réponse qui manquera, demain, aux humains comme aux machines.
Mes habitudes pour casser le réflexe
Prendre conscience qu’on n’a pas vérifié ce que dit l’IA est la première étape. À titre personnel, voici ce que j’essaie de faire :
- Je cherche d’abord. La documentation officielle de ce que je cherche, une recherche classique en ouvrant vraiment les pages, un forum. L’IA vient ensuite, pour gagner du temps sur ce que j’ai déjà compris.
- Je demande à être contredite. Plutôt que « pourquoi ma solution est la bonne ? », je demande « qu’est-ce qui ne va pas dans ma solution ? ».
- J’ouvre les sources. Une source citée ne vaut rien tant que je ne l’ai pas lue moi-même.
- Je me méfie de la précision. Un chiffre très exact, une date, un nom propre : ce sont justement les informations que l’IA invente le plus facilement.
- Je garde des humains dans la boucle. Collègues, communautés, experts : pour tout ce qui a des conséquences, un regard humain reste irremplaçable.
Une expérience pour tester votre propre réflexe
Je vous propose une petite expérience, la même que je m’impose. La prochaine fois qu’une question vous vient, attendez avant d’ouvrir l’IA :
- Notez votre question telle qu’elle vous vient.
- Cherchez cinq minutes par vous-même : la documentation, une vraie page de résultats, un forum, là où il y a de l’humain derrière quoi.
- Posez-la ensuite à l’IA, et comparez. Qu’a-t-elle ajouté ? Qu’a-t-elle oublié ? Qu’a-t-elle inventé ?
Vous serez peut-être surpris de voir combien de fois la réponse était à portée de main et combien de fois l’IA l’aurait légèrement déformée.
Alors, faut-il se fier à l’IA ?
L’IA reste un outil précieux et en 2026 elle est devenue difficile à éviter. Mais un outil qui ne doute jamais demande qu’on doute à sa place. C’est notre rôle, en tant qu’utilisateurs, de garder le dernier mot sur ce que l’on décide de croire, de diffuser et de relayer.
Et si l’expérience vous apprend quelque chose, partagez-là avec votre entourage (en plus Noël et ses dîners de fin d’année seront bientôt là, ambiance assurée!) car c’est en confrontant nos réflexes qu’on les comprend.
Crédit cover : Photo de Zulfugar Karimov sur Unsplash